跨境电商 AI 客服系统从 0 到 1(一):全景架构,与“发送权永不交给 LLM”这条红线
本系列记录我们用 Spring AI + Spring AI Alibaba 从零搭建一套跨境电商智能客服系统的完整过程——包括设计上的取舍、被评审掀过桌子的方案,和以后一定会踩的坑。这是第一篇:总体架构,以及贯穿整个系统的最重要的一条红线。
一、为什么是跨境客服
先交代背景。我们做的业务是跨境电商,客服面对的是三个渠道的买家咨询:网页聊天、邮件、社媒评论。这件事听起来和国内电商没什么区别——直到你真正去看咨询的结构,会发现几个国内几乎不存在的特性:
时区是错位的。 买家的活跃时间恰好是我们的深夜。传统做法是招多语种夜班坐席,成本曲线直接失控。
语言是复利式的。 英/德/法/西/日只是起步要求。每多开一个语种市场,客服团队就要多配一组人,而咨询量可能撑不起一个全职坐席。
响应时长直接挂钩店铺生死。 Amazon 要求 24 小时内响应买家消息,ODR(订单缺陷率)要压在 1% 以下;TikTok Shop、Shopee 的响应率直接影响流量权重。客服不再是成本中心,是店铺绩效的一环。
咨询的"高频题"和国内完全不同。 国内电商客服最常被问的是"什么时候发货"。跨境场景最高频的问题是"轨迹不动了"——国际干线运输中包裹轨迹静默 7~15 天是常态,买家当然会慌。其次是清关资料、关税、目的国适配性(电压、插头、尺码体系)。这些问题需要的是事实查询 + 时效基线知识,恰好是 AI 擅长、人力厌恶的那类工作。
所以对我们来说,AI 客服不是"降本增效的可选项",而是这个业务形态下的必需品。问题只剩一个:怎么做才不会翻车。
二、裸接 LLM 的三种死法
2026 年了,“接个大模型"仍然是大多数团队对 AI 客服的全部想象。把买家消息丢给模型、把回复发出去,一周内你就会体验以下三种死法:
死法一:幻觉式承诺。 模型会顺着买家的情绪说"您可以退货,运费我们承担”。但跨境退货的现实是:寄回国内的运费常在 15~40 美元,经常超过货值本身,所以真实的处置逻辑是一张成本决策矩阵——货值低于运费就退款不退货,轻微瑕疵部分退款,有海外仓就退本地仓。这张矩阵不在任何大模型的训练数据里,没有任何 RLHF 会让模型知道你们公司的退货成本。AI 说出口的每一句承诺,都是真金白银。
死法二:权限失控。 买家说"我是本人,帮我改一下收货地址",模型核对了订单号存在,就把地址改了。而"改地址"恰恰是跨境欺诈的经典手法——把货改寄到别处,再申请未收到货退款。
死法三:静默失败。 回复写得流畅得体,但进了垃圾箱;或者承诺"24 小时内会有同事联系您",而发出这条消息的时刻是凌晨三点,第二天也没有人接手。买家体验到的不是 AI 的局限性,是"这家店没人理我"。
三种死法的共同点是:没有一种死法是模型能力问题,全是工程问题。 这就是整个系统设计的出发点——
把"AI 说得对"和"AI 说了算"彻底分开。理解与表达交给大模型;门控、发送、校验、执行,全部是确定性代码。
三、总体架构:数据平面与控制平面
系统分成两个平面。数据平面干活:处理消息、查事实、写回复。控制平面管住 AI:审批、降级、观测。
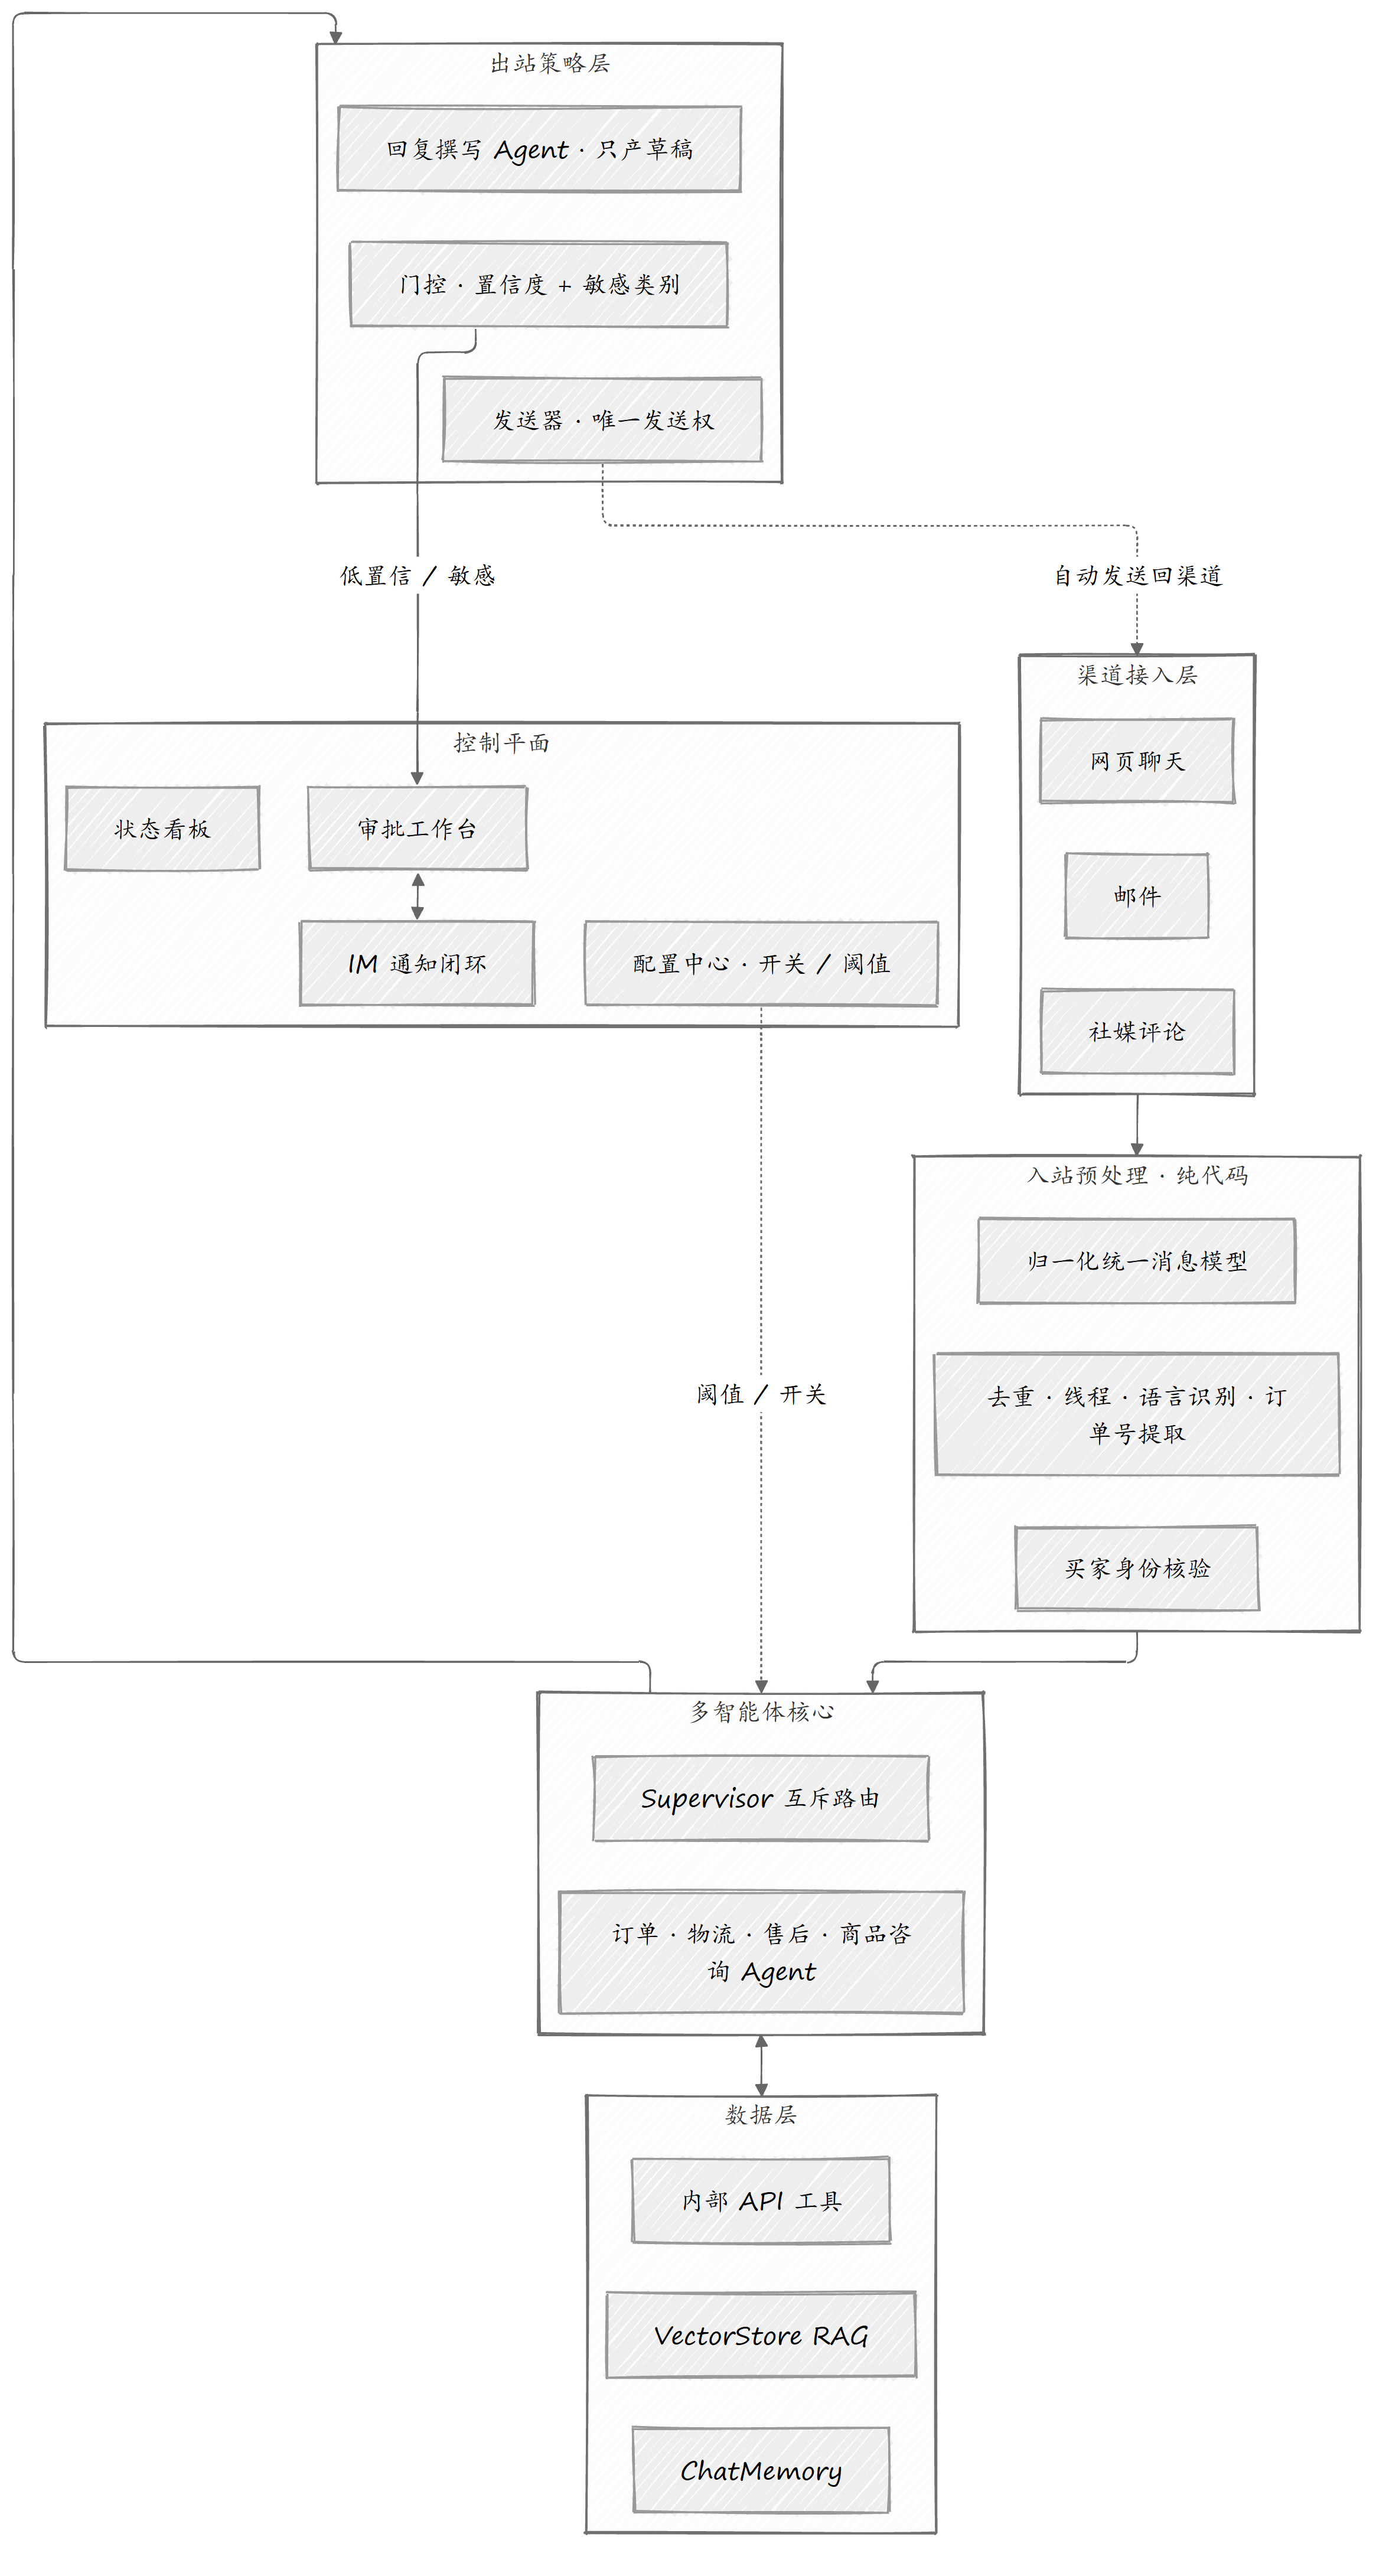
逐层说几个关键决策:
入站预处理 100% 是确定性代码,一行 LLM 都没有。 邮件的 Message-ID 去重、按 In-Reply-To 归并线程、语言识别、用正则提取订单号和快递单号——这些事让代码做,又快又稳又可测。特别强调"订单号提取":让 Agent 从自由文本里猜订单号,是把确定性逻辑拱手让给一个不可验证的系统。
出站策略层是整个系统安全性的核心。 回复撰写 Agent 的产出永远是"草稿",草稿走三层门控:第一层是确定性风控门(敏感类别、金额阈值、身份未核验、PII 模式,命中直接进人工,连置信度都不用算);第二层是置信度合成——由检索质量、工具成功率、事实覆盖率这些代码可计算的信号加权得到,后面会专门写一篇文章讲为什么不能信 LLM 自评;第三层是按渠道和类别标定的阈值判定。通过则自动发送,不通过进审批队列。
发送器是全系统唯一持有发送权的组件。 LLM 在任何环节都接触不到它。
控制平面里,最重要的东西便宜得反直觉:一个"总降级开关"(一键回到 100% 人工审核)和一个"自动发送总开关"。这两个开关要求在系统第一天就可用——所有花哨的智能,都要给它们让路。
四、六条设计原则
架构图是骨架,原则是筋。以下六条贯穿所有模块设计,前两条展开讲,其余点到为止:
原则一:渠道无关核心
Agent 核心不感知渠道。聊天、邮件、评论三渠道的差异全部消化在两端的适配层:入站适配器把平台消息转成统一消息模型,出站发送器把草稿转成平台格式。新增一个渠道 = 新增一对适配器,核心零改动。这套核心我们计划先跑聊天和邮件,社媒评论在 P6 阶段直接复用——这个设计到时候要接受检验。
原则二:语义不重叠
四个子 Agent 按**业务对象(名词)**划分,而不是按动词:订单、物流、售后、商品。重叠是路由错误的根源,我们设了三道防线,由硬到软:
- 工具互斥(最硬):数据归属哪个域,对应的接口只挂在该域的 Agent 上。物流 Agent 的工具列表里没有退款工单 API,它想越界也没有手段。查同一批数据的两个 Agent 各说各话,是所有多智能体系统里最难裁决的冲突——直接让冲突在物理上不可能发生。
- Supervisor 路由规则显式互斥:比如"退款/退货/换货 → 售后 Agent(即使提到订单)"。买家说"我要退款,订单怎么还不到",这是售后问题,不是物流问题——路由规则必须写死这种优先级。
- description 声明互斥:每个子 Agent 的描述里写明"只处理 X,不涉及 Y"。
原则三:事实单一来源
每个共享事实(金额、库存、时效)只允许一个 Agent 产出。金额以订单域为准,时效以物流域为准,其他 Agent 用占位符引用,不得另行估算——回复 Agent 的指令里写死:“时效以 {logistics.eta} 为准,金额以 {order.amount} 为准,不得引用任何未经工具返回的数字”。
原则四:结构化契约
子 Agent 之间传结构化 JSON(字段、类型、单位、时区),拒绝自由文本。LLM 的输出无法验证,但 schema 可以。
原则五:确定性代码优先(本系列的灵魂)
路由之外的逻辑——去重、门控、发送、校验——全部用代码,不依赖 LLM 自觉。举一段真实的门控骨架(简化):
// 第 1 层:确定性风控门——不依赖任何模型输出
RiskVerdict risk = riskRules.evaluate(draft, channel, category, buyerContext);
if (risk.isSensitive() || !buyerContext.identityVerified()) {
    reviewTaskService.enqueue(draft, risk);   // 进人工审批队列
    return;
}

// 第 2 层:置信度合成——检索质量/工具成功率/事实覆盖率,代码可计算,无 LLM 自评
double confidence = confidenceScorer.score(draft, retrievalTrace, toolTrace);

// 第 3 层:阈值判定(按渠道×类别查表,shadow 期数据标定)
if (confidence >= thresholdOf(channel, category)
        && !draft.needsHuman() && autoSendEnabled(storeId)) {
    mailSender.replyInThread(draft);          // 发送器执行
} else {
    reviewTaskService.enqueue(draft, risk);
}原则六:永不直连数据——Agent 不碰数据库,一律经带鉴权的内部 API 或带强制 filter 的向量检索。filter 是权限边界,不是检索的可选项。
五、走一遍完整链路:一封"包裹是不是丢了"的邮件
拿最高频的真实场景把整条链路串起来。买家发来一封德语邮件:“Mein Paket seit 10 Tagen nicht bewegt……"(我的包裹十天没动了),签名里有一个订单号。
- 入站(纯代码):ESP Webhook 收到 →
Message-ID去重 →In-Reply-To归并线程 → 语言识别:德语 → 正则提取订单号 → 通过 identity graph 定位到统一买家 ID; - 路由:Supervisor 判定为物流域,委派物流 Agent;
- 取数(结构化产出):物流 Agent 调轨迹 API——最后一条轨迹确实是 10 天前;调线路时效基线工具——该线路到目的国的历史时效是 12~18 天;产出结构化事实:
{status: "in_transit_silent", eta_baseline: "12-18 days", silent_days: 10}; - 撰写:回复撰写 Agent 按德语商务模板注入事实占位符,生成草稿;
- 门控:风控门未命中 → 置信度合成:工具全部成功、事实覆盖率 100%、检索命中正常 → 高于该渠道×类别阈值 → 自动发送,带
In-Reply-To回到原线程; - 记账:全链路 Trace 入库,token 成本归因到 Agent 和店铺。
注意 AI 在这条链路里实际只负责两件事:理解买家在问什么,以及用人话把事实说出来。其余每个环节——去重、提取、查询、基线判断、置信度、发送——都是确定性代码。轨迹静默这个最考验"安抚话术"的场景,靠的不是模型的想象力,是那个线路时效基线工具给出来的事实。
六、方案评审掀出的三个坑
这套方案我们自己评审了两轮,抓出三个如果直接开工会出事的问题。它们非常有代表性,每个都值得单独写一篇文章,这里先立此存照:
confidence ≥ 0.85这个数字没有任何依据。 初版方案用它做唯一的自动发送闸门,但没人能回答"0.85 怎么来的”。更糟的是,如果用 LLM 自评置信度,校准数据会告诉你:越流畅的编造,自评分越高——闸门在最需要它的时候失效。现在的方案是确定性信号合成 + shadow 期用真实人工审核数据标定阈值,标定完成前所有渠道 100% 人工审。- “订单号 + 手机尾号"的身份核验可以被暴力枚举。 尾号只有 10⁴ 的空间,订单号又能从物流面单获得。加了失败限流、指数退避、统一失败话术,并把核验分成 L0~L3 四级——改地址必须加验证码,因为改地址是欺诈重灾区。
- “7×24 覆盖"和"敏感事项 100% 人工参与"在人力上不可能同时成立。 这是纯数学问题:自动部分 7×24,人工部分按值班表覆盖,对外承诺必须与真实人力一致,无值班的时段要有隔夜安抚话术而不是静默。
注意这三个坑的共同点:没有一个出在"AI 不够聪明”,全部出在工程与组织的接缝处。 这也是本系列最想传达的东西。
七、技术栈与路线图
- 框架:Spring AI Alibaba(ReactAgent / SupervisorAgent / Graph 并行编排),内核 Spring AI;
- 模型:双档路由——路由、分类、常规问答用轻量模型,售后处置、复杂消解用旗舰模型;
- 存储:PostgreSQL + PGVector(业务 + 向量一体,起步不引入双库),Redis(去重、缓存、串行化);
- 可观测:Micrometer Observation + OpenTelemetry + Grafana,token 成本按 Agent/渠道/店铺归因出账。
整体 20 周路线图,第一阶段刻意安排了一周不写代码:验证内部 API 是否可得、数据是否授权、平台合规是否允许——这些才是 AI 落地项目最大的延期风险,也是下一篇文章的主题。
系列目录
| # | 文章 | 状态 |
|---|---|---|
| 01 | 全景架构:发送权永不交给 LLM(本文) | ✅ |
| 02 | 写代码前,我们先花两周证明项目能做 | ✍️ |
| 03 | 工具与 RAG:filter 是权限边界,不是可选项 | |
| 04 | 多智能体编排:语义不重叠与两阶段时序 | |
| 05 | 置信度门控:为什么不能信 LLM 自评 | |
| 06 | 邮件送达率:回复再好,进垃圾箱等于零 | |
| 07 | 从 shadow 到灰度:放开比例是数据问题 | |
| 08 | 坐席助手:同一条数据平面的第三种出口 | |
| 09 | 上线复盘:指标 vs 基线的诚实对账 | |
| 番外 | 评测体系 / 身份核验与防爆破 / SAA 踩坑集 |
下一篇:《写代码前,我们先花两周证明项目能做》——内部 API spike 的真实结果、数据授权的坑,以及为什么"接口契约清单"比任何架构图都重要。感兴趣可以关注追更。